AI/MLインフラの性能を支えるネットワーク構築技術とは?
DCネットワーク本部 ネットワークプロダクト部 菅原 剛宏
キーワード
こんにちは、ネットワークプロダクト部の菅原です。私は、シスコ社のデータセンターネットワーク製品を中心に、それらを取り扱う方々への技術サポートを担当しています。
生成AIの普及に伴い、多くの企業でAI基盤の構築や活用が進んでいます。
AI基盤というとGPUやサーバーに注目が集まりがちですが、それらを効率よく連携させるためにはネットワークも重要な役割を担います。
近年、AI学習環境(AI/MLインフラ)において、GPUの性能をより効率的に活用するための技術としてRDMA over Converged Ethernet Version 2(RoCEv2)が注目されています。
本記事では、RoCEv2の概要やInfiniBandとの違い、Fibre Channel over Ethernet(FCoE)から発展したConverged Ethernet技術について、分かりやすく解説します。
近年、生成AIをはじめとするAI技術が急速に普及し、多くの企業でAI活用の取り組みが進んでいます。AIシステムを構築する際には、高性能なGPUやサーバーが注目されますが、それらを接続するネットワークも同じくらい重要な役割を担っています。
例えば、大規模言語モデル(LLM)の学習では、複数のGPUサーバーが連携して膨大なデータを処理します。このとき、GPU同士で大量のデータをやり取りするため、ネットワークの速度や品質が十分でなければ、GPUが通信待ちの状態となり、本来の性能を発揮できなくなります。
こうした課題を解決する技術として注目されているのが、RoCEv2です。
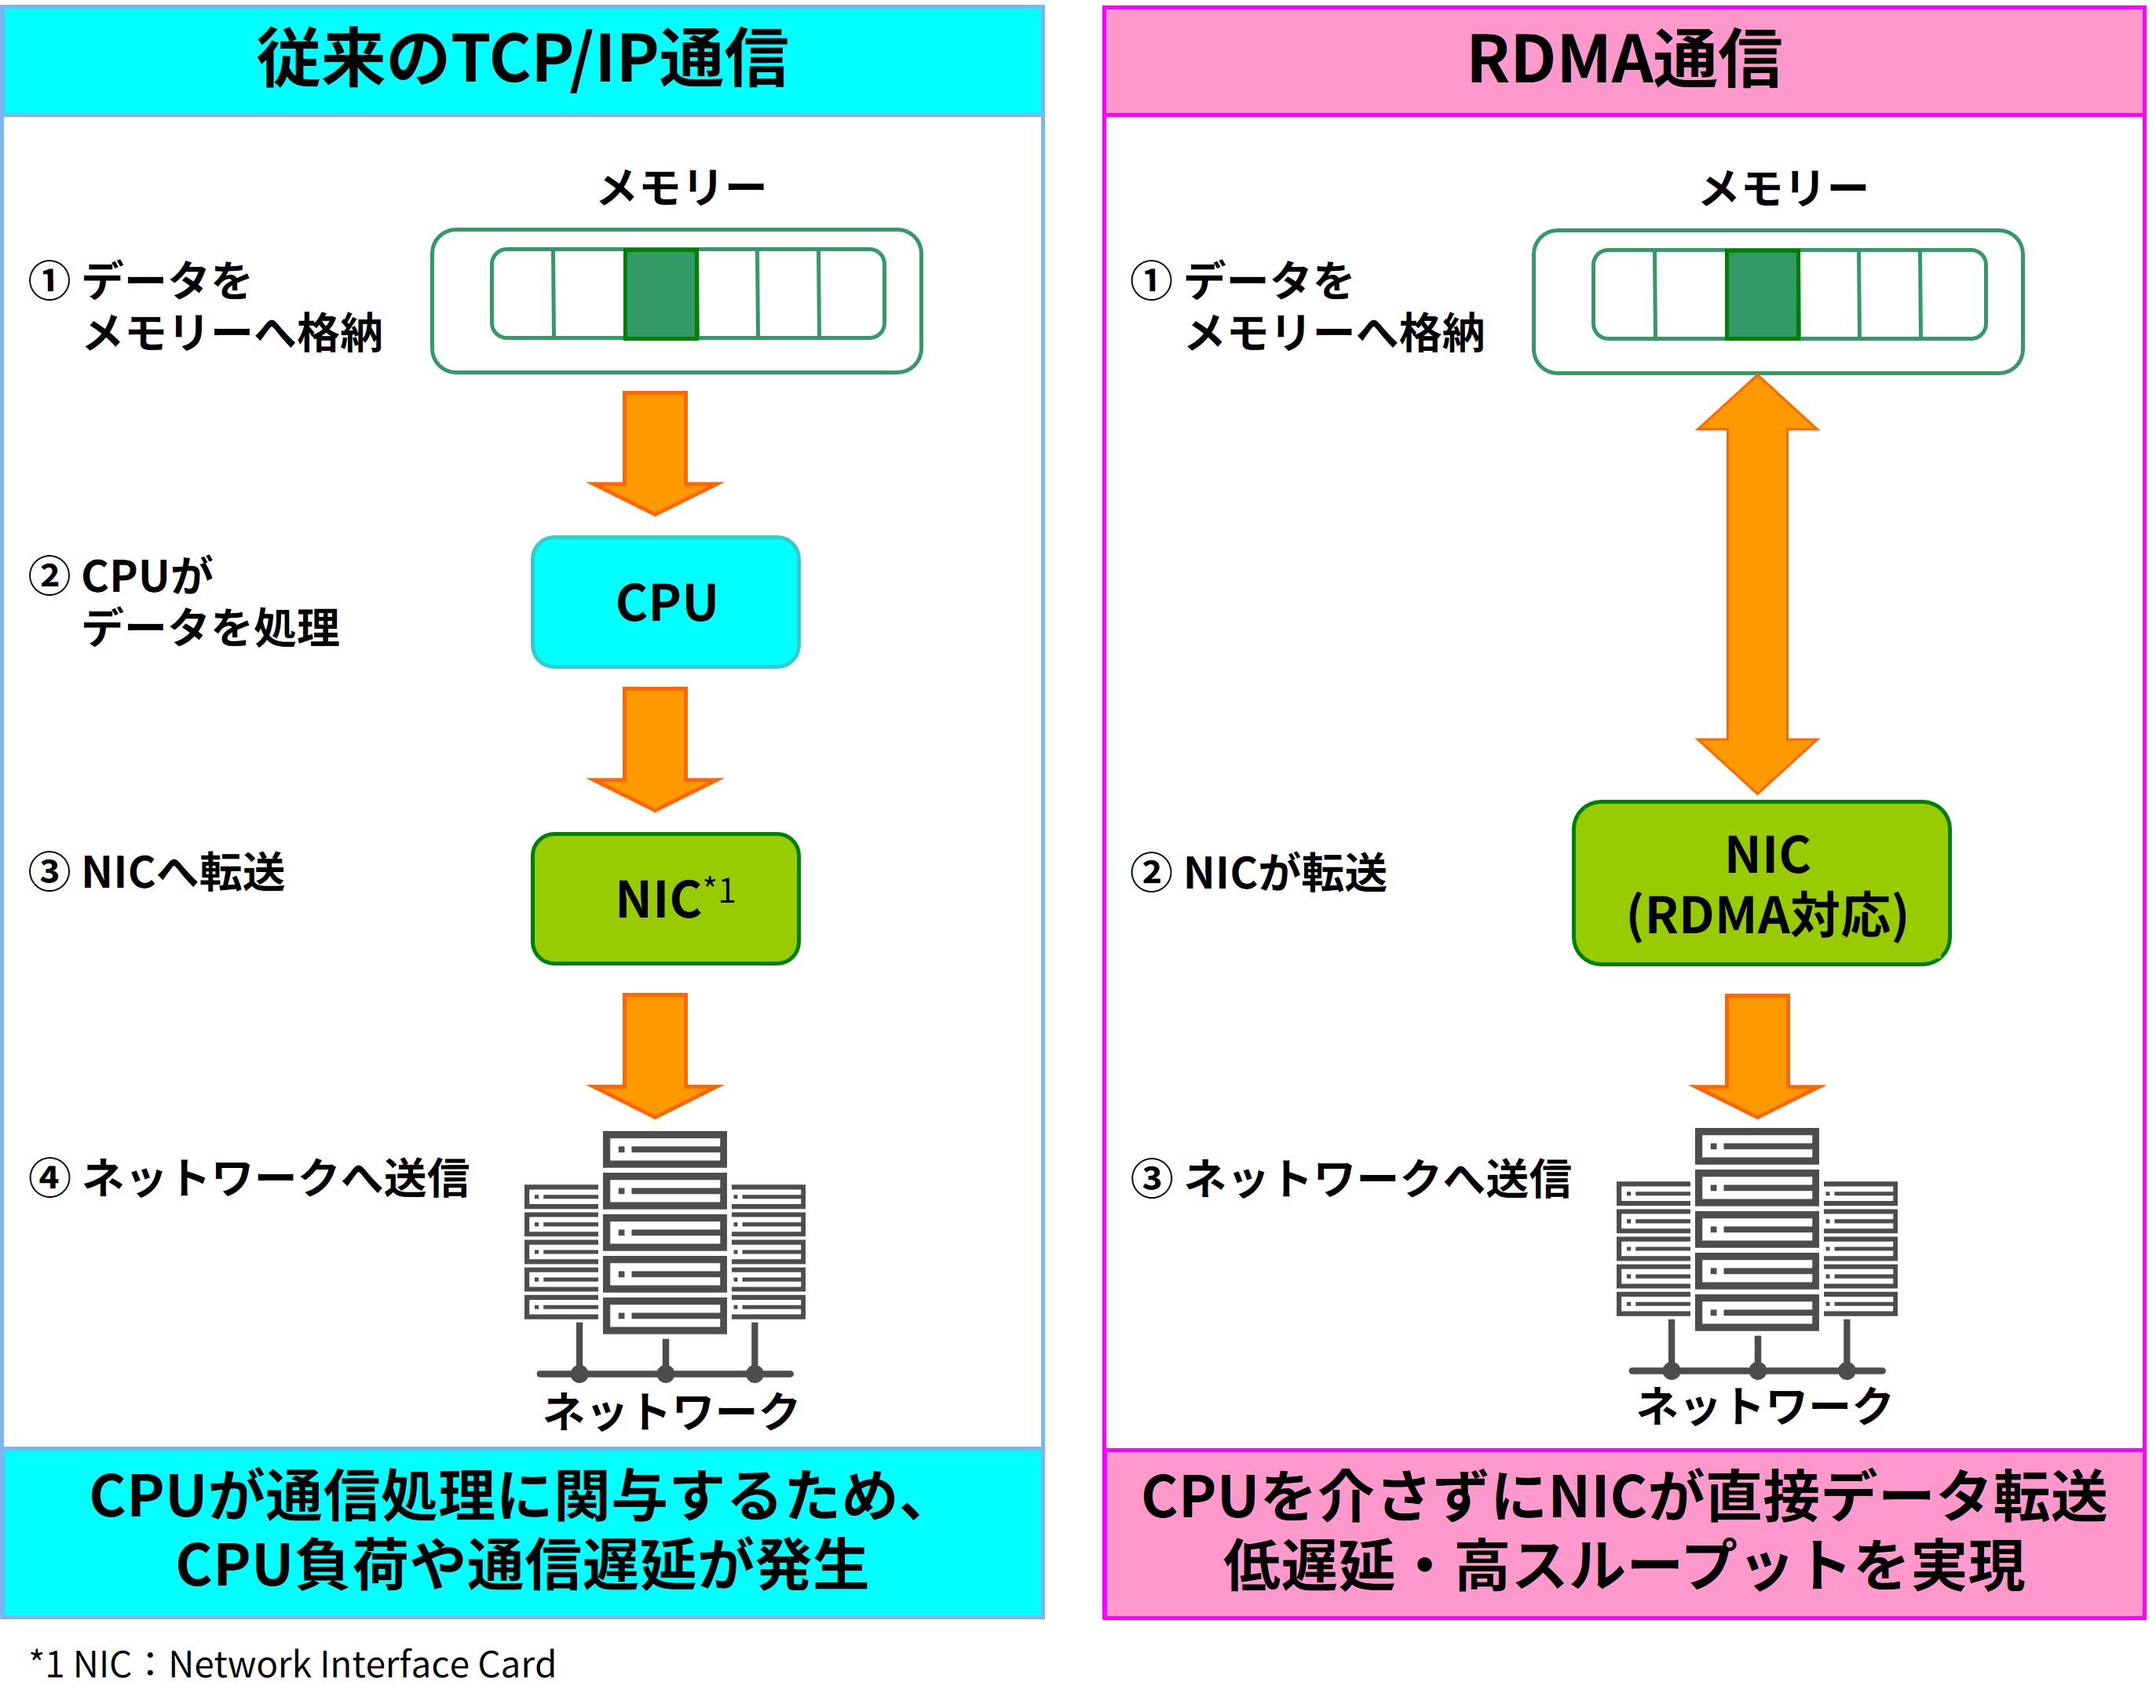
RoCEv2を理解する前に、まずはRDMA(Remote Direct Memory Access)について簡単に説明します。RDMAとは、サーバー間でデータを転送する際に、CPUを介さずにメモリーへ直接アクセスできる通信技術です。通常の通信ではCPUがデータ転送処理を行うため負荷や遅延が発生しますが、RDMAではCPUの介在を最小限に抑えられるため、低遅延・高スループットな通信を実現できます。
このため、AI学習環境やHPC(High Performance Computing:高性能計算)環境で広く利用されています。一方で、パケットロスの影響を受けやすいという特性があり、パケットロスを抑制したネットワーク環境が重要になります。
RDMAの性能を最大限に発揮するため、従来はInfiniBandが広く利用されてきました。InfiniBandはHPC向けに開発された専用ネットワーク技術であり、低遅延・高スループットな通信を実現できます。また、パケットロスを極力排除する設計となっているため、RDMAとの相性が非常に良いことが特徴です。現在も大規模AIシステムで利用されていますが、専用のスイッチやアダプタが必要となるため、イーサーネットと比べると導入・運用のハードルが高くなる場合があります。
そこで注目されているのが、既存のイーサーネット環境を活用できるRoCEv2です。
RoCEv2は、サーバー間のデータ転送を高速化するRDMA技術を、一般的なイーサーネット上で利用できるようにした通信方式です。専用技術であるInfiniBandに対し、既存のイーサーネット環境や運用ノウハウを活用できるため、多くの企業が導入しやすいことが特長です。
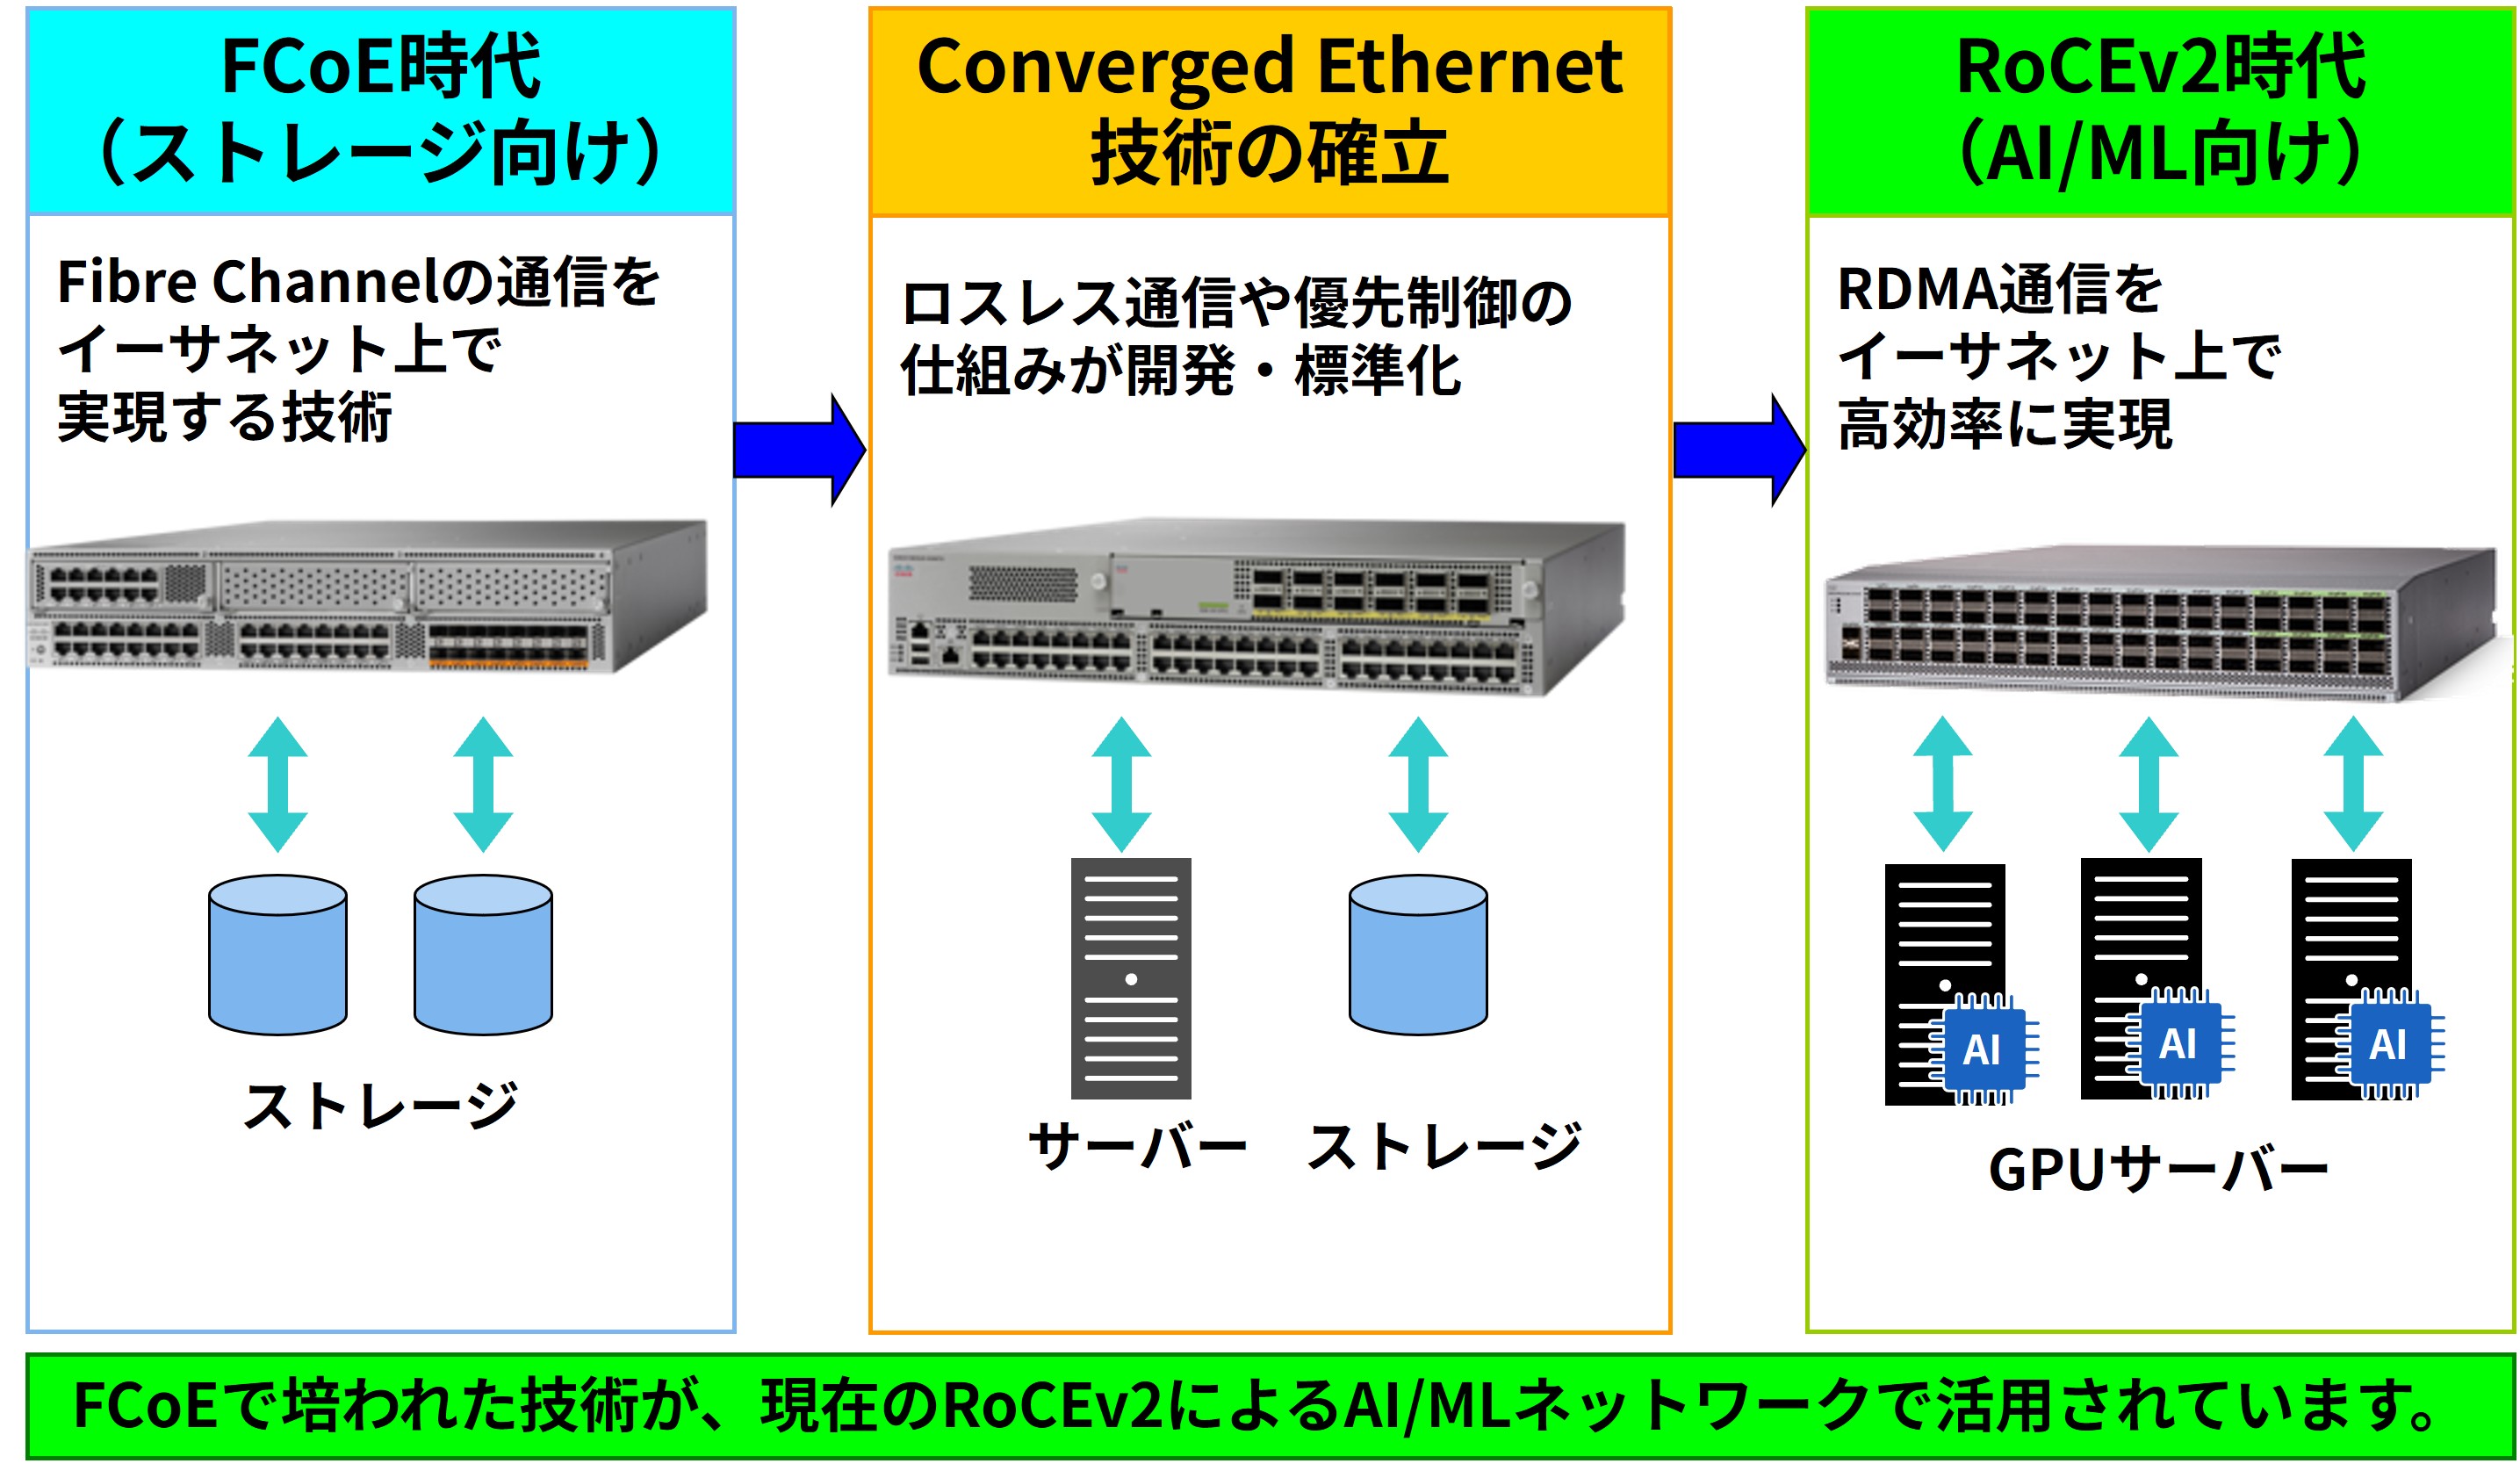
RoCEv2を支えるのがConverged Ethernetです。これは、サーバー通信やストレージ通信など異なるトラフィックを単一のイーサーネット基盤へ統合し、高い通信品質を実現するための技術群です。
つまり、AI向けネットワークで利用されるロスレス技術のルーツの一つは、ストレージネットワークにあると言えます。
従来のEthernetでは、ふくそう(輻輳)時にパケットを破棄して通信を制御しますが、この「パケットロスを許容する設計」はAI/ML環境では大きな課題となります。RoCEv2通信でパケットロスが発生すると再送処理が発生し、GPU間通信の遅延増加や学習効率の低下につながるためです。
そのためRoCEv2では、パケットロスを極力抑えたロスレスネットワークが求められます。その実現に利用されるのがExplicit Congestion Notification(ECN)とPriority Flow Control(PFC)です。ECNは混雑を早期に検知して送信側へ通信量の抑制を通知し、PFCは重要なトラフィックのパケットロスを防ぎます。
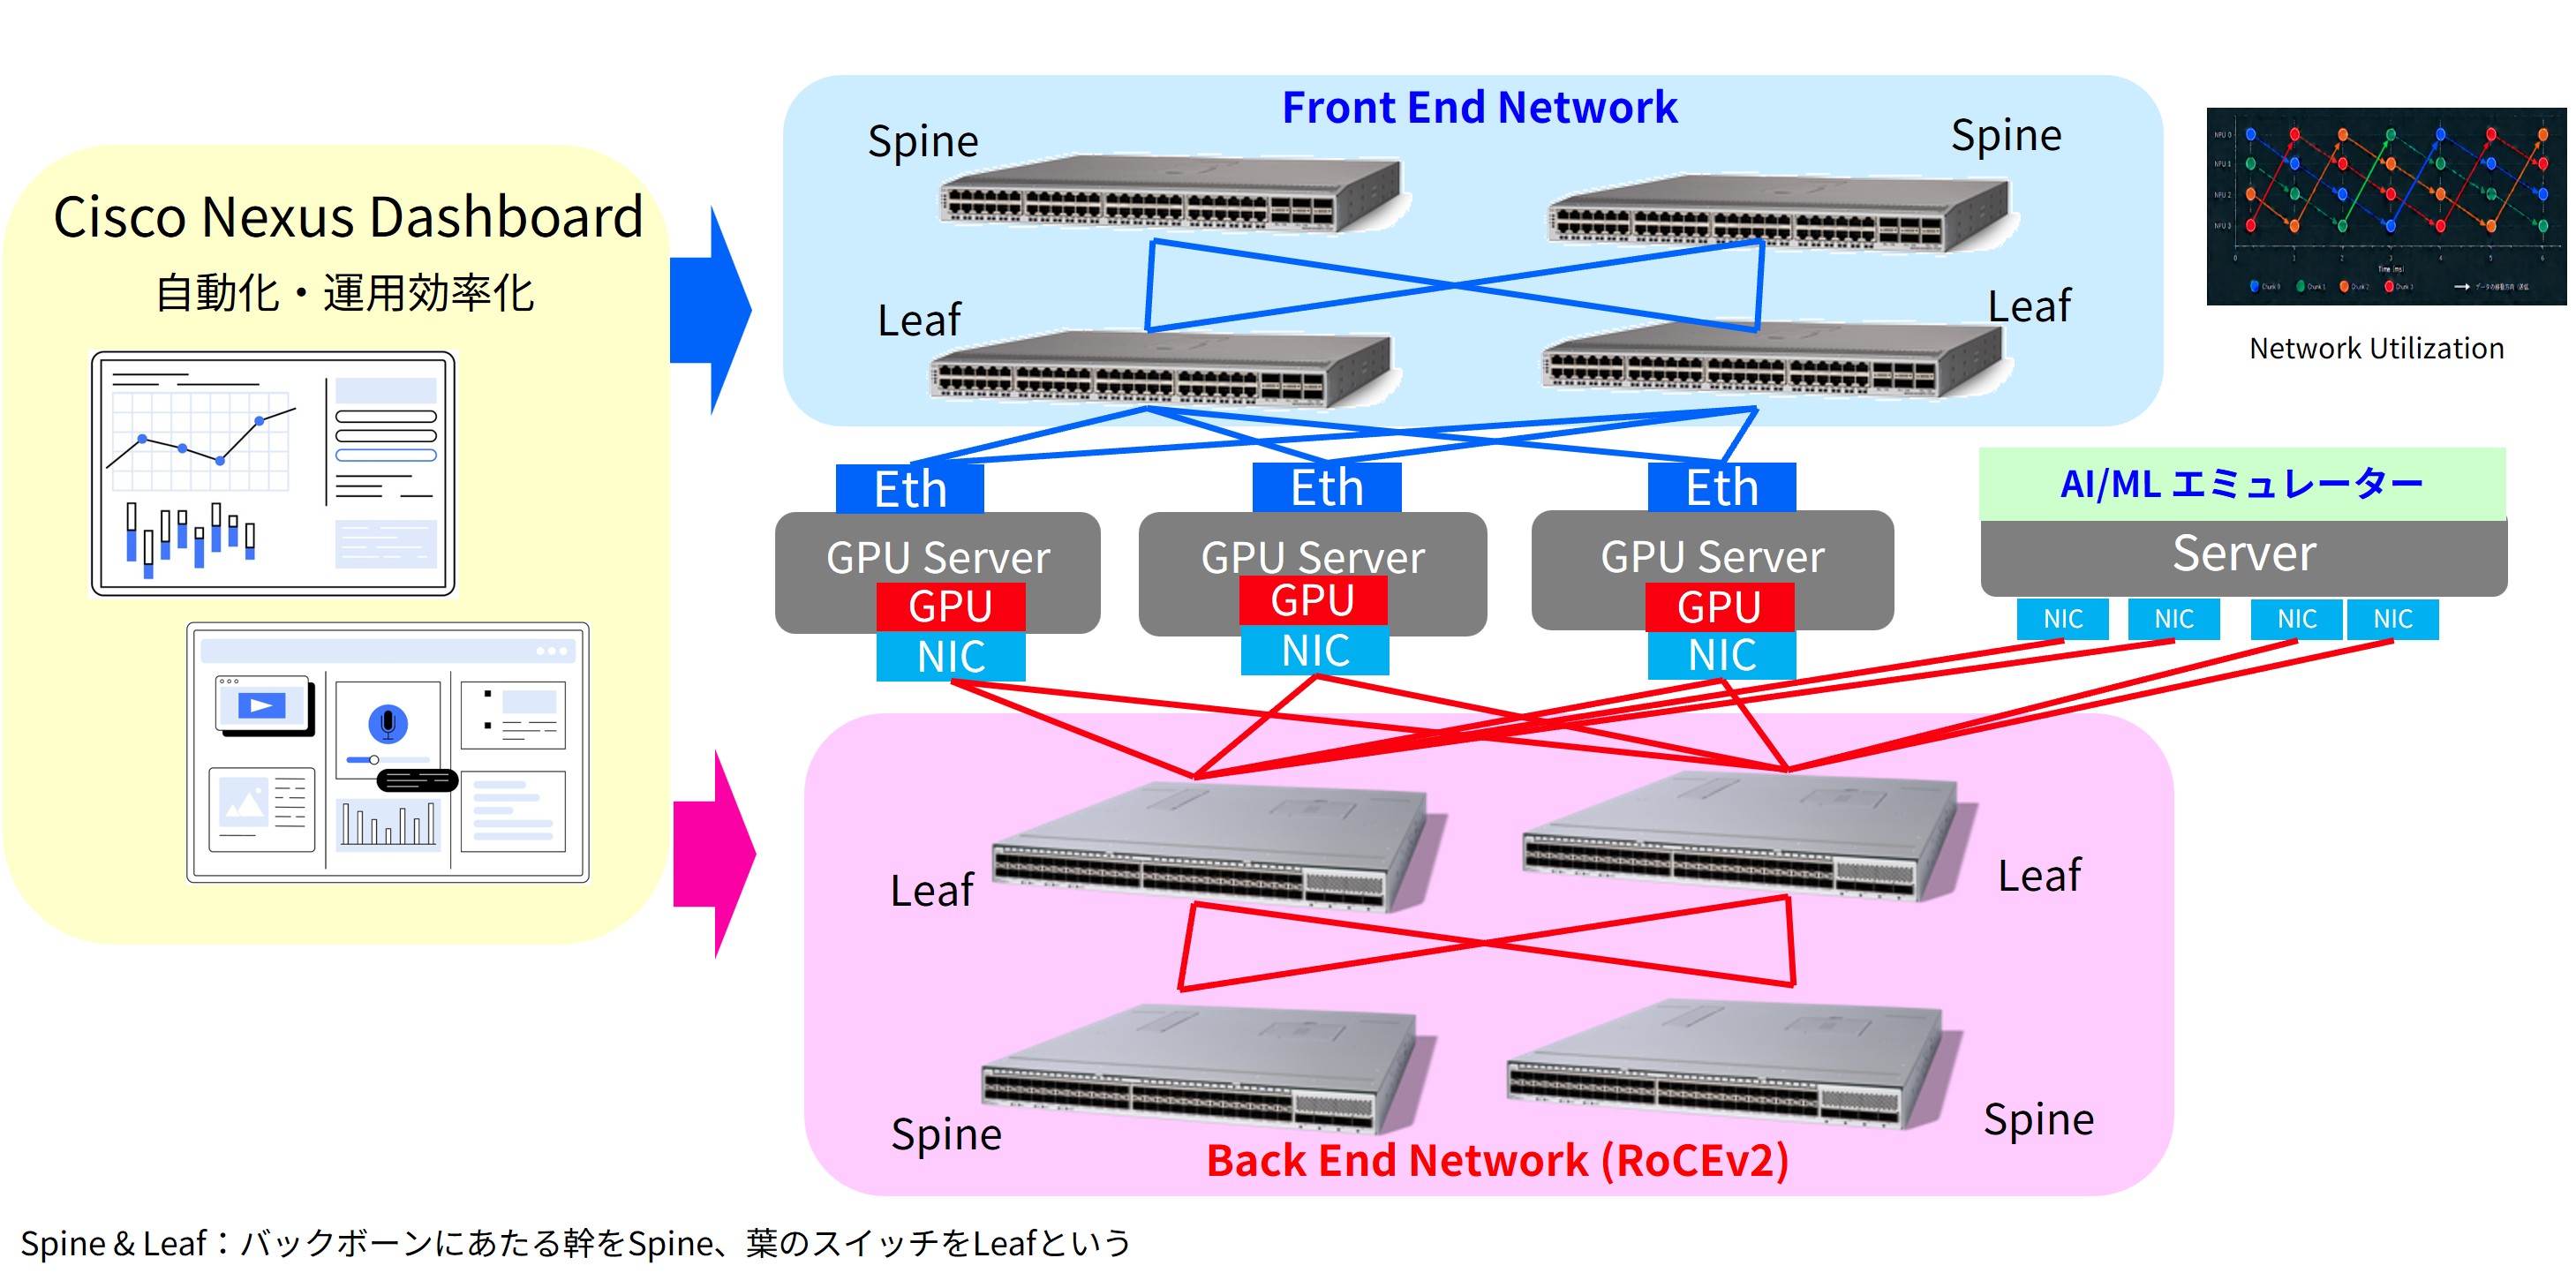
AI/ML分野においては、NVIDIAが提示するAI基盤向けのReference Architecture(NVIDIA Cloud Partner Reference Architecture:NCP-RA)が事実上の標準となっています。当社では、Cisco Nexus 9000シリーズを用いてNVIDIA推奨のネットワーク要件に準拠した環境を構築し、AI/MLエミュレーターによる性能評価を実施しました。その結果、NVIDIA Reference Architectureと同等のパフォーマンスを実現し、GPUリソースの有効活用や学習時間の短縮が可能であることを確認しています。
さらに、Nexus Dashboardを利用することで、RoCEv2に必要なAI/MLネットワークの設定を自動化できるため、設定ミスの防止や導入期間の短縮を図りながら、効率的かつ安定したネットワーク運用を実現できます。
生成AIの普及に伴い、AIシステムの性能を最大限に引き出すためには、GPUやサーバーだけでなく、ネットワークも重要な要素となっています。RoCEv2は、既存のEthernet環境を活用しながら高速・低遅延な通信を実現できる技術です。また、その背景には、かつてCisco NexusやCisco UCSで活用されたFCoEを支えるConverged Ethernet技術があります。
AI/MLインフラでは、GPUやサーバーの性能だけでなく、それらを接続するネットワークまで含めて最適化することが重要です。高性能なハードウェアを導入しても、ネットワークがボトルネックとなれば期待どおりの性能を得ることはできません。
当社では、NCP-RAの設計思想を踏まえつつ、シスコ製品を用いて実装レベルまで具体化したReference Architecture(Cisco Cloud Reference Architecture)の検証に取り組んでいます。RoCEv2を活用したAI/ML基盤の構築をご検討の際は、ぜひご相談ください。
2026年11月
株式会社 日立情報通信エンジニアリング
ネットワーキング事業部 DCネットワーク本部 ネットワークプロダクト部 菅原 剛宏
※編集・執筆当時の記事のため、現在の情報と異なる場合があります。編集・執筆の時期については、記事末尾をご覧ください。

